Die Organigramm-Falle: Wie man AI-Skills und Agents organisiert
Installier genug Skills, und deine AI hört still und leise auf, sie zu benutzen. Gib jedem Agent einen Jobtitel, und sie fangen an, sich zu widersprechen. Ich habe die beliebtesten Agent-Setups auf GitHub, die offenen Issues und die Benchmarks gelesen, um zu sehen, was wirklich funktioniert — sechs Setups, ihre Vor- und Nachteile, und das eine, mit dem ich heute anfangen würde.
Es gibt einen Bug-Report, der mir nicht aus dem Kopf geht. Jemand hatte eine schöne Sammlung von Skills in Claude Code installiert — kleine Playbooks, die der AI jeweils beibringen, eine bestimmte Aufgabe gut zu erledigen. Dann bat er um genau so eine Aufgabe. Und statt das Playbook aufzuschlagen, das exakt dafür geschrieben war, hat Claude ein frisches Ad-hoc-Script von Grund auf gebaut, als gäbe es den Skill gar nicht.
Aus Sicht des Modells gab es ihn auch nicht. Die Skill-Liste war über das Budget hinausgewachsen, das das Tool dafür reserviert, und die Beschreibungen — das Einzige, was das Modell liest, bevor es sich entscheidet — wurden stillschweigend abgeschnitten. Der Skill lag noch auf der Platte. Er hatte nur kein Namensschild mehr. (anthropics/claude-code#64606)
Diese Geschichte ist das ganze Problem im Kleinen. Wir sammeln Skills wie Apps auf dem Handy, und wir bauen Agents, als würden wir eine Firma aufbauen: ein CTO, ein Head of Marketing, ein Coach, ein Stratege. Fühlt sich organisiert an. Und arbeitet still und leise gegen uns.
Angefangen habe ich mit einer simplen Ahnung. Wäre es nicht sauberer, wenn Skills nicht allen zur Verfügung stünden, sondern bestimmten Agents gehörten — so wie Werkzeuge zu einer bestimmten Werkstatt gehören? Also habe ich gemacht, was ich inzwischen bei jeder solchen Frage mache: Ich habe drei Research-Agents parallel losgeschickt. Einer hat dreizehn der beliebtesten Agent-Setups auf GitHub geklont und gelesen. Einer hat sich durch Erfahrungsberichte aus der Praxis und Hacker-News-Threads gearbeitet. Einer hat verglichen, wie die großen Agent-Frameworks dasselbe Problem lösen, und die Benchmark-Zahlen zusammengetragen.
Die Ahnung lag halb richtig. Hier ist, was zurückkam.
Erst mal: Wie ein Skill überhaupt beim Modell ankommt
Ein Skill ist ein Ordner mit einer SKILL.md-Datei. Ganz oben steht ein kurzer Header:
---
name: release-notes
description: Write release notes from merged PRs. Use when the user asks
  for a changelog, release notes, or "what shipped this week".
---
Zu Beginn jeder Session sieht das Modell deine Skills nicht. Es sieht eine Liste: Name und Beschreibung jedes Skills. Erst wenn es entscheidet, dass ein Skill passt, lädt es die vollständigen Anweisungen. Das nennt sich Progressive Disclosure, und es ist ein gutes Design — hundert Playbooks kosten dich hundert kurze Zeilen, nicht hundert Dokumente.
Aber die Liste hat ein Budget. In Claude Code sind das etwa 1 % des Context Windows, und jeder Eintrag ist auf 1.536 Zeichen begrenzt. Läuft die Liste über, fliegen zuerst die Beschreibungen deiner am wenigsten genutzten Skills raus. Die Namen bleiben. Die Bedeutung geht. (Doku)
Wie schnell beißt das zu? Ein kleines Experiment hat 160 Dummy-Skills installiert: Claude Code behielt die Beschreibungen von etwa 20 davon, und das Modell fand null von drei Skills, die nur mit Namen gelistet waren (Rulestack). Winzige Stichprobe, synthetische Namen — aber es deckt sich mit den Bug-Reports. Vercel hat einen saubereren Eval mit der Doku ihres eigenen Frameworks gemacht und festgestellt, dass der Skill in 56 % der Fälle nie aufgerufen wurde (Vercel).
Also Regel Nummer eins: Ein Skill ohne Beschreibung ist ein Skill, den es nicht gibt.
Drei Schalter entscheiden, wer einen Skill sehen kann:
| Header | Du kannst ihn aufrufen (/name) | Modell wählt ihn selbst | Kostet Platz in der Liste |
|---|---|---|---|
| (Standard) | ja | ja | ja |
user-invocable: false | nein | ja | ja |
disable-model-invocation: true | ja | nein | nein |
Achte auf die Falle in der mittleren Zeile. Einen Skill vor dir selbst zu verstecken, macht die Liste des Modells kein bisschen kürzer. Wenn es dir um Fokus geht, ist der letzte Schalter der entscheidende — oder den Skill gar nicht erst zu installieren.
Sechs Setups, die Leute tatsächlich nutzen
Jedes populäre Repo, das ich gelesen habe, hat sich für eines davon entschieden, oft ohne es auszusprechen. Keines ist falsch. Jedes scheitert auf vorhersehbare Weise.
1. Die Schublade — alles global
Du findest einen tollen Katalog, lässt den Installer laufen, und schon hast du dreihundert Skills. Die meisten großen Sammlungen fangen hier an: Kataloge mit Installern, Mega-Bundles mit „alles installieren“-Profilen.
Vorteile: null Nachdenken. Alles ist nur einen Slash entfernt. Nachteile: Die Liste läuft über, Beschreibungen werden abgeschnitten, und das Modell findet nichts mehr. Du zahlst für Skills, die du nie gelesen hast. Ein Kommentar auf Hacker News hat es unverblümt auf den Punkt gebracht — Leute installieren massenhaft Bundles im Wert von fünfzigtausend Tokens, die sie nicht verstehen (HN).
Bezeichnenderweise warnen die größten Bundles inzwischen vor sich selbst. Eines der Setups mit den meisten Stars, mit Hunderten von Skills, liefert Install-Profile mit — minimal, core, developer — und empfiehlt, mit den gemeinsamen Regeln plus einem Paket anzufangen, das du wirklich nutzt (ECC).
2. Der Router — eine Eingangstür
Statt siebzig Skills zu listen, listest du einen: einen Hub, der weiß, wo die anderen wohnen.
---
name: gstack
description: Router for the gstack skill suite.
triggers:
  - gstack
  - which gstack skill
---
Das stammt aus garrytan/gstack, und die haben es gemessen: Alle Skills zu listen kostete etwa 18.000 Zeichen und wurde abgeschnitten; der Router-Modus kam mit etwa 6.700 aus. BMAD-METHOD macht dasselbe mit einem bmad-Hub-Skill.
Vorteile: Die Liste bleibt kurz; eine gute Beschreibung leitet auf viele weiter.
Nachteile: ein zusätzlicher Hop, und der Router muss aktuell bleiben. Leg die Sub-Skills in einen references/-Ordner, auf den der Router zeigt, statt sie als Liste reinzukopieren — wie gstack anmerkt, veraltet eine reinkopierte Liste.
3. Die Werkstatt — Skills, die ihre eigenen Agents mitbringen
Das war am nächsten an meiner ursprünglichen Ahnung, und das Eleganteste, was ich gefunden habe. Eine der Skill-Sammlungen mit den meisten Stars auf GitHub, obra/superpowers, liefert null Agent-Definitionen mit. Stattdessen leben die Subagents innerhalb des Skills, der sie benutzt:
skills/subagent-driven-development/
  SKILL.md                 ← the controller: one fresh worker per task
  implementer-prompt.md    ← an "agent" that exists only here
  task-reviewer-prompt.md  ← and its reviewer
Der Skill schickt pro Aufgabe einen frischen Implementer los, danach einen Reviewer, und die Übergaben werden in Dateien geschrieben, statt in die Konversation kopiert. Anthropics eigener skill-creator macht es genauso: ein Grader, ein Comparator und ein Analyzer als private Dateien, die der Skill nur liest, wenn er sie braucht.
Vorteile: Die Agents sind wirklich privat. Niemand sonst sieht sie, und in keiner anderen Session kosten sie etwas. Nachteile: Sie sind nicht über Skills hinweg wiederverwendbar, und du verlierst die netten Features einer echten Agent-Definition — eigene Tool-Liste, eigenes Modell, eigene Berechtigungen.
In den Notizen von superpowers stecken zwei Lektionen, die man klauen sollte. Ein Dispatch war 42.000 Zeichen lang, und 99 % davon waren reinkopierte History — deshalb reisen Artefakte als Dateien. Und Worker dürfen keine eigenen Reviewer starten, weil jeder Reviewer, den ein Worker gestartet hat, nur das Review wiederholt hat, das der Controller ohnehin schon machte.
4. Der Werkzeugkasten — Plugins als Einheit
Ein Plugin bündelt Agents, Skills, Hooks und Tool-Server in ein installierbares Paket. wshobson/agents verteilt rund zweihundert Agents auf vierundneunzig Plugins, im Schnitt fünf oder sechs Komponenten pro Stück, unter dem Motto install only what you need. Anthropics offizielle Plugins sind ebenfalls klein — jeweils ein bis neun Agents.
Das beste First-Party-Beispiel für Scoping ist Anthropics Security-Plugin. Der Skill deklariert genau, welche Agents er aufrufen darf:
# skills/claude-security/SKILL.md
allowed-tools:
  - Agent(claude-security:scan-inventory, claude-security:scan-verifier, ...)
und der Verifier-Agent deklariert, was er aufrufen darf:
# agents/scan-verifier.md
description: Restricted read-only verifier ... not for direct invocation.
tools: Read, Glob, Grep, Bash, Agent(claude-security:explore)
Vorteile: Das ist echtes Scoping. Ein Skill lebt in derselben Kiste wie die Agents, die ihn benutzen, und du schaltest ganze Kisten pro Projekt an und aus.
Nachteile: Du pflegst jetzt Pakete. Und das Kleingedruckte ist noch in Bewegung: Offene Issues berichten, dass verschachtelte Agent(...)-Allowlists manchmal ignoriert werden (#92259), und dass Einstellungen zum Verstecken von Skills Plugin-Skills noch nicht erreichen (#98220).
Ein Wort zur naheliegenden Alternative. Agents in Claude Code haben ein skills:-Feld, und das sieht genau nach dem Scoping aus, das ich wollte:
---
name: release-manager
skills: [release-notes, changelog-style]
---
Ist es aber nicht. Es lädt den vollen Text dieser Skills beim Start in den Agent vor — es nimmt sie niemand anderem weg. Laut Doku steuert es das Vorladen, nicht den Zugriff (Doku), Agent Teams ignorieren es komplett, und der Wunsch, einen Skill vor der Haupt-Session zu verstecken, ist immer noch ein offenes Issue (#12633). In den dreizehn Repos, die ich gelesen habe, habe ich null echte Verwendungen davon gefunden.
5. Das Organigramm — Agents mit Jobtiteln
Das ist das Setup, das jeder zuerst baut, weil es so gut dazu passt, wie wir ohnehin über Arbeit denken. Ein CTO-Agent. Ein Marketing-Agent. Ein Product Manager. Ein Coach.
---
name: cto
description: Chief Technology Officer. Owns architecture, code quality,
  deployments and engineering decisions.
---
Es fühlt sich an wie Delegieren. Die Evidenz sagt: Meistens ist es das nicht.
Anthropics eigene Empfehlung vom Januar ist eindeutig: Teil die Arbeit nach Context-Grenzen auf, nicht nach Rollen. Aufteilungen in Planner, Implementer und Tester wurden zur Stillen Post, bei jeder Übergabe gingen Details verloren (Anthropic). Auf Hacker News berichteten Leute, die PM- und Backend-Developer-Personas ausprobiert hatten, dass die schlechter abschnitten als ein einzelner generischer Agent, und ein Kommentar fasste es so zusammen: build agents around tasks, not job titles (HN). Ein Autor, der sieben Rollen-Agents laufen ließ, stellte fest, dass sie ordentliche Entwürfe lieferten, die aber nie die Arbeit der anderen gesehen hatten — der Product-Agent strich ein Feature, von dem das Datenmodell noch ausging, und die Widersprüche zusammenzuführen blieb am Menschen hängen. Der wertvollste der sieben Agents war der adversariale Reviewer (Rezvani).
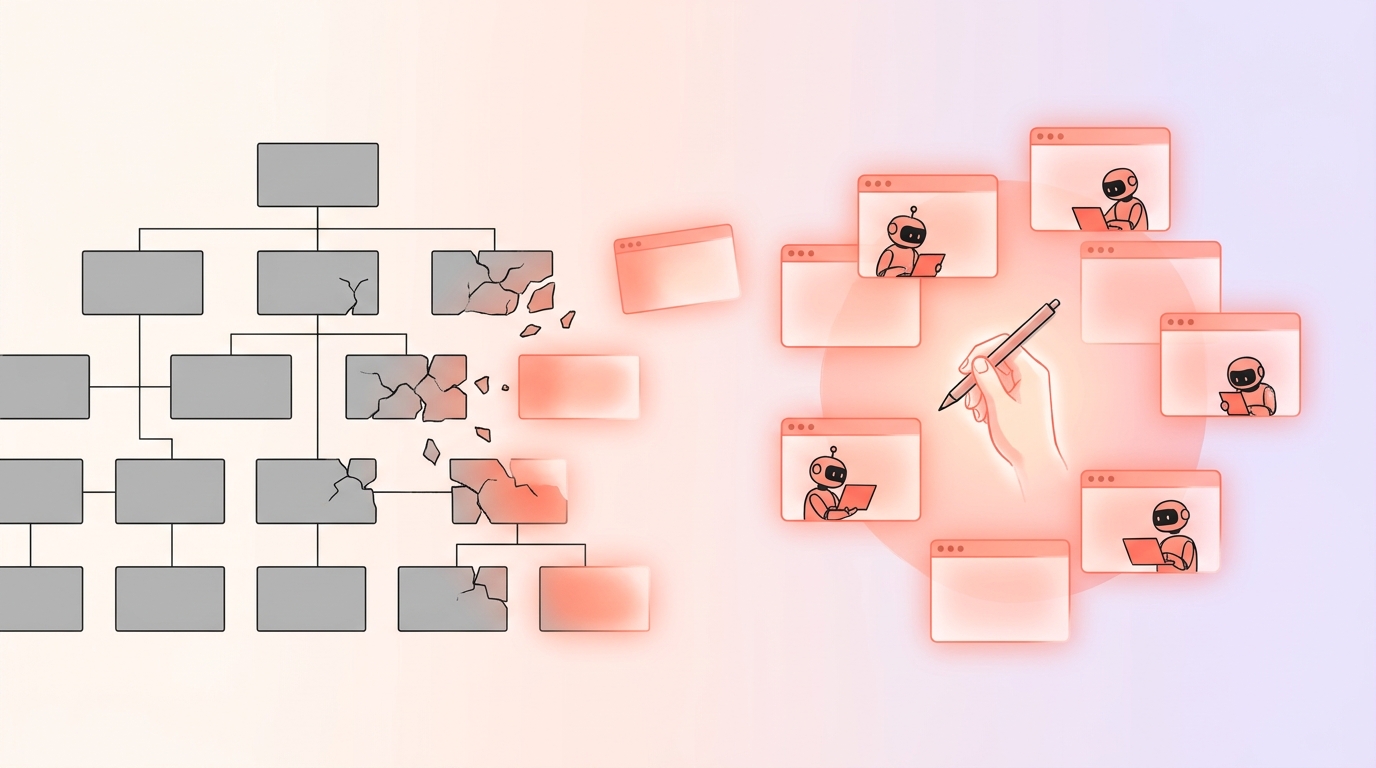
Warum? Ein Organigramm ist eine Lösung für menschliche Grenzen: Wir können nicht eine ganze Firma im Kopf behalten, also teilen wir sie nach Expertise auf. Ein Modell hat die Expertise schon. Seine Grenze ist eine andere — es ist der Context. Wer nach Titeln aufteilt, schneidet den Context genau an den falschen Stellen durch.
Vorteile: leicht zu erklären, leicht zu routen („frag den CTO“). Nachteile: oberflächliche Spezialisten, verlorener Context, Widersprüche, die du selbst zusammenführen musst.
Wenn du an den Personas hängst, gibt es einen günstigeren Weg, sie zu behalten: Mach sie zu Skills. BMAD liefert überhaupt keine Agent-Dateien mit; „John, der Product Manager“ ist ein Skill, den sich der Haupt-Agent wie einen Hut aufsetzt — mit der ganzen Konversation weiterhin im Blick.
6. Der Schwarm — Agents, die miteinander reden
Am anderen Ende: viele Agents, die gleichzeitig laufen, sich gegenseitig Nachrichten schicken und Aufgaben von einer gemeinsamen Liste beanspruchen. Claude Code hat dafür einen experimentellen Agent-Teams-Modus; Repos wie ruflo (früher claude-flow) bauen Hive-Minds mit einer Queen als Koordinatorin und gemeinsamem Speicher.
Manchmal ist das spektakulär. Anthropic hat sechzehn Agents einen C-Compiler schreiben lassen, ganz ohne Orchestrator — jeder schnappte sich per Lock-Datei eine Aufgabe und mergte über git. Das kostete etwa 20.000 $ an Tokens, und die wichtigste Lektion war, dass es nur dank einer nahezu perfekten Test-Suite funktioniert hat. Als alle Agents an einer großen Aufgabe arbeiteten, liefen alle in denselben Bug und überschrieben sich gegenseitig (Anthropic).
Ein Engineer hat ein Agent-Team genutzt, um einen Produktionsvorfall zu untersuchen: Root Cause in etwa zehn Minuten statt geschätzter dreißig bis fünfundvierzig, zum drei- bis vierfachen Preis (magarcia). Lohnt sich bei einem Ausfall. Nicht bei einem Tippfehler.
Vorteile: echte Parallelität; Agents können die Hypothesen der anderen anfechten. Nachteile: Die Tokens skalieren mit der Zahl der Agents, bei allem Sequenziellen frisst die Koordination die Gewinne auf, und wie es ein Review eines populären Schwarm-Frameworks formulierte: Das Design wird zum Flaschenhals (Maggie Appleton). Selbst die Frameworks ziehen sich zurück: Ein beliebtes Setup hat seinen Schwarm-Skill zugunsten kleiner Teams entfernt und eine Team-Bridge gelöscht, weil sie nie jemand benutzt hat (oh-my-claudecode).
Wie man Agents miteinander verdrahtet
Zieh das Branding ab, und jedes Framework — Claude Code, OpenAIs Agents SDK, LangGraph, CrewAI, Googles ADK — bietet dieselben vier Formen:
| Form | Wie sie funktioniert | Nutze sie, wenn |
|---|---|---|
| Orchestrator → Worker | Ein Agent verteilt Aufgaben, Worker liefern Zusammenfassungen zurück | Teilaufgaben unabhängig sind oder viel Rauschen erzeugen |
| Handoff | Ein Triage-Agent übergibt die Konversation an einen Spezialisten | Der Spezialist direkt mit dem User sprechen soll |
| Hierarchie | Orchestratoren von Orchestratoren | Ein einzelner Koordinator zu viele Worker hätte |
| Peer-Team | Agents schreiben sich gegenseitig und teilen eine Aufgabenliste | Konkurrierende Hypothesen, Writer–Reviewer-Schleifen |
Die Zahlen dazu, wann sich das auszahlt, sind überraschend konsistent:
- Anthropics Multi-Agent-Research-System schlug einen einzelnen Agent bei Research-Aufgaben um 90 % — und verbrauchte dabei etwa 15× so viele Tokens wie ein Chat. Den Großteil des Codings halten sie für einen schlechten Fit (Anthropic).
- Google hat 180 Konfigurationen getestet: Ein zentraler Koordinator brachte +81 % bei parallelen Aufgaben, aber jede Multi-Agent-Variante wurde bei sequenzieller Planung 39–70 % schlechter. Unabhängige Agents verstärkten Fehler bis zu 17×; ein zentraler Koordinator hielt es bei etwa 4× (Google Research).
- Eine Studie mit mehr als 1.600 Multi-Agent-Traces ergab, dass der wirksamste Einzelfix ein zusätzlicher Verifikationsschritt war: +15,6 % (MAST).
- Cognition, die bekanntlich „Don't Build Multi-Agents“ geschrieben haben, haben ihre Sicht im April aktualisiert: Es funktioniert, wenn Schreibzugriffe single-threaded bleiben und die zusätzlichen Agents Denkarbeit beisteuern — ein Reviewer mit sauberem Context, ein stärkeres Modell zum Eskalieren (Cognition).
Und die Form, die in den Repos, die funktionieren, immer wieder auftaucht: ein schlanker Orchestrator, Worker mit frischem Context, State in Dateien und ein Review-Gate. So deklariert get-shit-done einen Worker — achte darauf, dass dort steht, wer ihn starten darf:
---
name: gsd-executor
description: Executes plans with atomic commits. Spawned by the
  execute-phase orchestrator.
tools: Read, Write, Edit, Bash, Grep, Glob
---
Der gesamte Projekt-State lebt in .planning/STATE.md und ROADMAP.md — niemals nur in einem Chat. Jeder Agent kann sterben, und der nächste macht einfach ab der Datei weiter.
Wenn du einen Orchestrator willst, der nur bestimmte Worker aufrufen darf, kannst du das in Claude Code festlegen, wenn er als Haupt-Session läuft:
---
name: coordinator
tools: Agent(researcher, implementer, reviewer), Read, Grep
---
Das Setup, mit dem ich heute anfangen würde
Wenn ich das von null aufsetzen würde, mit dem Wissen von heute:
- Halt die globale Liste klein — zwanzig oder dreißig Skills, die du wirklich nutzt, jeder mit einer Beschreibung, die mit den Worten beginnt, die ein User sagen würde. Prüf, was das Tool tatsächlich anzeigt (
/doctorin Claude Code schätzt die Kosten der Liste). - Bündel Familien hinter Routern. Neun „Daily Review“-Schritte werden zu einem Skill mit neun Referenzdateien.
- Markier gefährliche Skills als user-only. Alles, was Geld ausgibt oder eine Nachricht verschickt, bekommt
disable-model-invocation: true. Das schafft nebenbei Platz in der Liste. - Nutz Plugins als Kisten. Eine Domäne — sagen wir Videoproduktion — wird ein Plugin mit ihren Agents und Skills zusammen, eingeschaltet dort, wo sie gebraucht wird.
- Benenn Agents nach Aufgaben, nicht nach Titeln.
researcher,reviewer,explorer— oder ein Router, der in einen anderen Projektordner mit eigenen Anweisungen wechselt. Ein anderer Ordner ist eine echte Context-Grenze. „CTO“ ist keine. - Verdrahte sie als Orchestrator → Worker → Reviewer, mit State in Dateien. Ein Schreiber. Worker starten keine Worker.
- Greif nur dann zu einem Team, wenn Agents streiten müssen — drei konkurrierende Theorien zu einem Ausfall, nicht der Bau eines Features.
Und noch eins, geborgt aus der Doku: Wenn eine Regel jedes Mal gelten muss, gehört sie überhaupt nicht in einen Skill. Ein Skill ist eine Bitte. Ein Hook ist Durchsetzung.
Die eigentliche Lektion
Ich bin mit der Frage gestartet: Wem sollte welcher Skill gehören? Die Antwort, die die Recherche immer wieder lieferte, war eine andere Frage: Wo bricht der Context?
Organigramme, Jobtitel, Abteilungen — das sind brillante Erfindungen für Menschen, weil Menschen nicht alles gleichzeitig im Kopf behalten können. Unsere Agents haben eine anders geformte Grenze. Sie können für ein paar Minuten Experte in allem sein, aber nur in dem, was sie sehen können. Sie zu organisieren heißt also nicht, Kästchen und Berichtslinien zu zeichnen. Es heißt zu entscheiden, was jeder von ihnen sehen muss, und dafür zu sorgen, dass nichts Wichtiges zwischen die Fenster fällt.
Bau weniger Agents. Schreib bessere Beschreibungen. Leg den State dort ab, wo ihn jeder lesen kann. Und lass nur eine Hand den Stift führen.
Gedanken zu diesem Beitrag? Lass uns auf X diskutieren!

Alösha
Baue Community-Plattformen auf, unterrichte Salsa, schreibe, um meine Leute zu finden.