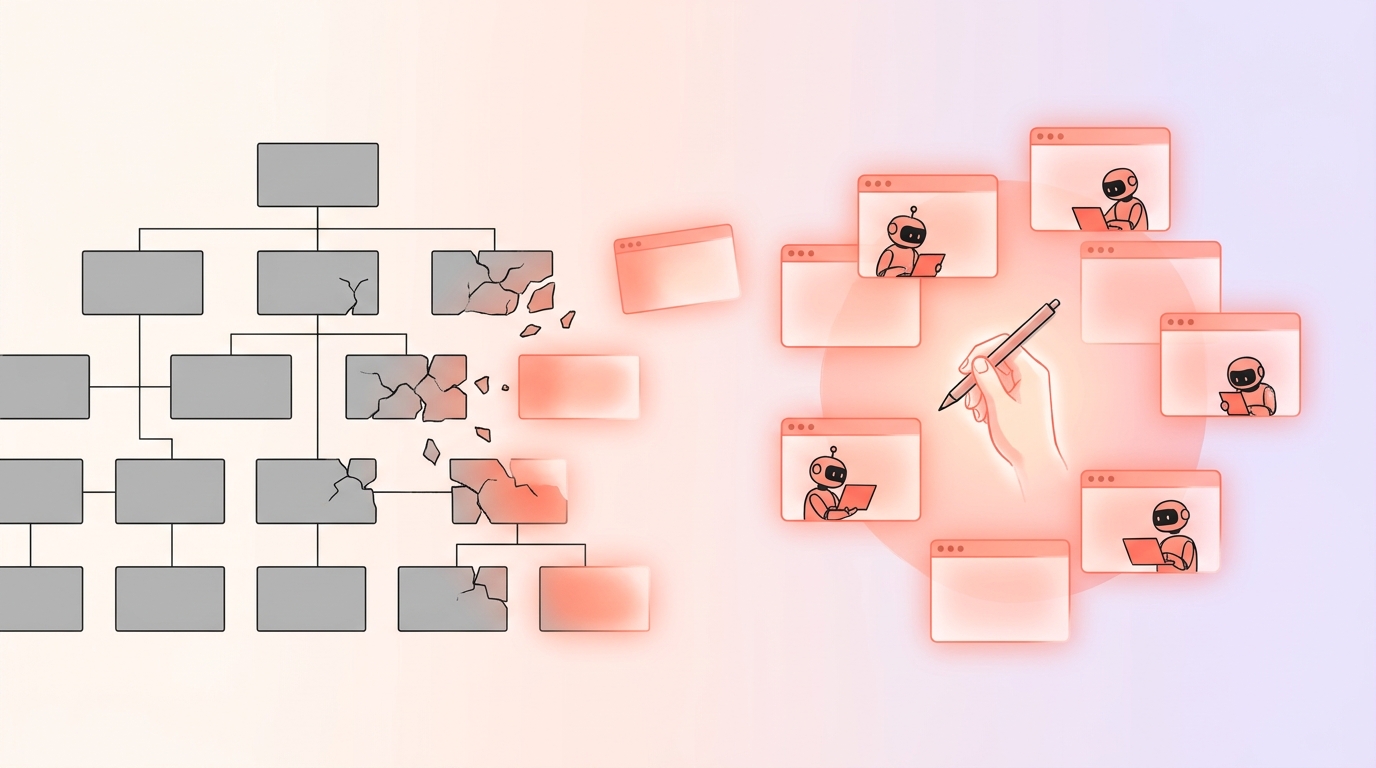
La trampa del organigrama: cómo organizar skills y agentes de IA
Instala suficientes skills y tu IA deja de usarlas sin avisar. Dale a cada agente un cargo y empiezan a contradecirse. Leí los setups de agentes más populares de GitHub, los issues abiertos y los benchmarks para ver qué funciona de verdad: seis setups, sus pros y contras, y el que yo elegiría hoy para empezar.
Hay un bug report que no me puedo quitar de la cabeza. Alguien tenía instalada en Claude Code una buena colección de skills: pequeños manuales, cada uno enseñándole a la IA a hacer bien un trabajo concreto. Pidió uno de esos trabajos. Y en lugar de abrir el manual escrito exactamente para eso, Claude se puso a escribir un script improvisado desde cero, como si la skill no existiera.
Desde el punto de vista del modelo, no existía. La lista de skills había superado el presupuesto que la herramienta le reserva, y las descripciones —lo único que el modelo lee antes de elegir— se habían recortado sin avisar. La skill seguía en el disco. Simplemente ya no tenía etiqueta con su nombre. (anthropics/claude-code#64606)
Esa historia es todo el problema en miniatura. Coleccionamos skills como apps en el móvil, y montamos agentes como si estuviéramos contratando para una empresa: un CTO, un jefe de marketing, un coach, un estratega. Parece ordenado. Y en silencio juega en nuestra contra.
Empecé con una intuición sencilla. ¿No sería más limpio que las skills no estuvieran disponibles para todos, sino que pertenecieran a agentes concretos, igual que las herramientas pertenecen a un taller concreto? Así que hice lo que ahora hago con cada pregunta de este tipo: mandé tres agentes de investigación en paralelo. Uno clonó y leyó trece de los setups de agentes más populares de GitHub. Otro repasó artículos de gente que trabaja con esto a diario e hilos de Hacker News. El tercero comparó cómo resuelven el mismo problema los grandes frameworks de agentes y sacó los números de los benchmarks.
La intuición resultó acertada a medias. Esto es lo que volvió.
Primero: cómo llega realmente una skill al modelo
Una skill es una carpeta con un archivo SKILL.md. Arriba del todo hay una cabecera corta:
---
name: release-notes
description: Write release notes from merged PRs. Use when the user asks
  for a changelog, release notes, or "what shipped this week".
---
Al empezar cada sesión, el modelo no ve tus skills. Ve una lista: el nombre y la descripción de cada skill. Solo cuando decide que una encaja carga las instrucciones completas. Esto se llama divulgación progresiva (progressive disclosure), y es un buen diseño: cien manuales te cuestan cien líneas cortas, no cien documentos.
Pero la lista tiene un presupuesto. En Claude Code es más o menos el 1% de la ventana de contexto, y cada entrada tiene un tope de 1.536 caracteres. Cuando la lista se desborda, lo primero que cae son las descripciones de las skills que menos usas. Los nombres se quedan. El significado se va. (docs)
¿Qué tan rápido muerde esto? Un pequeño experimento instaló 160 skills de prueba: Claude Code mantuvo las descripciones de unas 20, y el modelo encontró cero de tres skills que aparecían solo con su nombre (Rulestack). Muestra minúscula, nombres sintéticos, pero cuadra con los bug reports. Vercel hizo una evaluación más limpia con la documentación de su propio framework y encontró que la skill no se invocó nunca en el 56% de los casos (Vercel).
Así que regla número uno: una skill sin descripción es una skill que no existe.
Hay tres interruptores que deciden quién puede ver una skill:
| Cabecera | Puedes llamarla tú (/name) | El modelo la elige solo | Ocupa espacio en la lista |
|---|---|---|---|
| (por defecto) | sí | sí | sí |
user-invocable: false | no | sí | sí |
disable-model-invocation: true | sí | no | no |
Fíjate en la trampa de la fila del medio. Ocultarte una skill a ti mismo no hace más corta la lista del modelo. Si lo que buscas es foco, el interruptor que importa es el último, o directamente no instalar la skill.
Seis setups que la gente usa de verdad
Cada repo popular que leí ha elegido uno de estos, muchas veces sin decirlo. Ninguno está mal. Cada uno falla de una forma predecible.
1. El cajón: todo global
Encuentras un catálogo genial, ejecutas el instalador y ahora tienes trescientas skills. La mayoría de las grandes colecciones empiezan aquí: catálogos con instaladores, megapaquetes con perfiles de "instálalo todo".
Pros: cero esfuerzo mental. Todo está a un slash de distancia. Contras: la lista se desborda, las descripciones se recortan y el modelo deja de encontrar cosas. Pagas por skills que nunca has leído. Un comentarista de Hacker News lo dijo sin rodeos: la gente instala a granel paquetes de cincuenta mil tokens que no entiende (HN).
Lo revelador es que los paquetes más grandes ya advierten contra sí mismos. Uno de los setups con más estrellas, con cientos de skills, trae perfiles de instalación —minimal, core, developer— y recomienda empezar con las reglas comunes más un paquete que de verdad uses (ECC).
2. El router: una sola puerta de entrada
En vez de listar setenta skills, listas una: un hub que sabe dónde viven las demás.
---
name: gstack
description: Router for the gstack skill suite.
triggers:
  - gstack
  - which gstack skill
---
Eso viene de garrytan/gstack, que lo midió: listar todas las skills ocupaba unos 18.000 caracteres y se truncaba; el modo router ocupaba unos 6.700. BMAD-METHOD hace lo mismo con una skill hub llamada bmad.
Pros: la lista sigue siendo corta; una buena descripción enruta hacia muchas.
Contras: un salto extra, y el router tiene que mantenerse al día. Pon las subskills en una carpeta references/ a la que apunte el router, no en una lista pegada: como señala gstack, una lista pegada se queda obsoleta.
3. El taller: skills que traen sus propios agentes
Este fue el más cercano a mi intuición original, y lo más elegante que encontré. Una de las colecciones de skills con más estrellas de GitHub, obra/superpowers, trae cero definiciones de agentes. En su lugar, los subagentes viven dentro de la skill que los usa:
skills/subagent-driven-development/
  SKILL.md                 ← the controller: one fresh worker per task
  implementer-prompt.md    ← an "agent" that exists only here
  task-reviewer-prompt.md  ← and its reviewer
La skill lanza un implementador nuevo por cada tarea y luego un revisor, y los traspasos se escriben en archivos en lugar de pegarse en la conversación. El propio skill-creator de Anthropic hace lo mismo: un evaluador, un comparador y un analizador como archivos privados que la skill solo lee cuando los necesita.
Pros: los agentes son privados de verdad. Nadie más los ve, y no cuestan nada en ninguna otra sesión. Contras: no se pueden reutilizar entre skills, y pierdes las ventajas de una definición de agente real: su propia lista de herramientas, su modelo, sus permisos.
Las notas de superpowers tienen dos lecciones que vale la pena robar. Un despacho ocupaba 42.000 caracteres, y el 99% era historial pegado; por eso los artefactos viajan como archivos. Y los workers tienen prohibido lanzar sus propios revisores, porque cada revisor que lanzaba un worker solo duplicaba la revisión que el controlador hacía de todos modos.
4. La caja de herramientas: plugins como unidad
Un plugin agrupa agentes, skills, hooks y servidores de herramientas en un solo paquete instalable. wshobson/agents reparte unos doscientos agentes en noventa y cuatro plugins, con una media de cinco o seis componentes cada uno, bajo el lema instala solo lo que necesitas. Los plugins oficiales de Anthropic también son pequeños: de uno a nueve agentes cada uno.
El mejor ejemplo de acotación hecho por la propia Anthropic es su plugin de seguridad. La skill declara exactamente qué agentes puede llamar:
# skills/claude-security/SKILL.md
allowed-tools:
  - Agent(claude-security:scan-inventory, claude-security:scan-verifier, ...)
y el agente verificador declara a qué puede llamar él:
# agents/scan-verifier.md
description: Restricted read-only verifier ... not for direct invocation.
tools: Read, Glob, Grep, Bash, Agent(claude-security:explore)
Pros: esto sí es acotar de verdad. Una skill vive en la misma caja que los agentes que la usan, y enciendes o apagas cajas enteras por proyecto.
Contras: ahora te toca mantener paquetes. Y la letra pequeña todavía se está moviendo: hay issues abiertos que reportan que las allowlists anidadas de Agent(...) a veces se ignoran (#92259), y que los ajustes para ocultar skills todavía no llegan a las skills de plugins (#98220).
Una nota sobre la alternativa obvia. Los agentes de Claude Code tienen un campo skills:, y parece justo la acotación que yo quería:
---
name: release-manager
skills: [release-notes, changelog-style]
---
No lo es. Lo que hace es precargar el texto completo de esas skills en el agente al arrancar; no se las quita a nadie más. La documentación dice que controla la precarga, no el acceso (docs), los agent teams lo ignoran por completo, y la petición para ocultar una skill de la sesión principal sigue siendo un issue abierto (#12633). En los trece repos que leí, no encontré ni un solo uso real.
5. El organigrama: agentes con cargo
Este es el setup que todo el mundo monta primero, porque encaja con cómo ya pensamos el trabajo. Un agente CTO. Un agente de marketing. Un product manager. Un coach.
---
name: cto
description: Chief Technology Officer. Owns architecture, code quality,
  deployments and engineering decisions.
---
Se siente como delegar. La evidencia dice que casi nunca lo es.
La guía que publicó la propia Anthropic en enero es directa: divide el trabajo por frontera de contexto, no por rol. Las divisiones planificador–implementador–tester acabaron siendo un teléfono descompuesto, y en cada traspaso se perdían detalles (Anthropic). En Hacker News, quienes probaron personas de PM y de backend developer contaron que rendían peor que un único agente genérico, y un comentario lo resumió así: construye agentes en torno a tareas, no a cargos (HN). Un autor que trabajó con siete agentes por rol vio que producían borradores decentes que nunca veían el trabajo de los demás: el agente de producto eliminó una funcionalidad que el modelo de datos seguía dando por hecha, y fusionar las contradicciones le tocó al humano. El agente más valioso de los siete fue el revisor adversarial (Rezvani).
¿Por qué? Un organigrama es la solución a límites humanos: no podemos tener una empresa entera en la cabeza, así que la dividimos por especialidad. Un modelo ya tiene la especialidad. Su límite es otro: el contexto. Dividir por cargo corta el contexto justo por donde no debe.
Pros: fácil de explicar, fácil de enrutar ("pregúntale al CTO"). Contras: especialistas superficiales, contexto perdido, contradicciones que tienes que fusionar tú.
Si te encantan las personas, hay una forma más barata de conservarlas: conviértelas en skills. BMAD no trae ningún archivo de agente; "John, el Product Manager" es una skill que el agente principal se pone como un sombrero, sin perder de vista toda la conversación.
6. El enjambre: agentes que hablan entre sí
En el otro extremo: muchos agentes a la vez, mandándose mensajes, reclamando tareas de una lista compartida. Claude Code tiene un modo experimental de agent teams para esto; repos como ruflo (antes claude-flow) montan mentes colmena con una reina coordinadora y memoria compartida.
A veces es espectacular. Anthropic puso a dieciséis agentes a escribir un compilador de C sin ningún orquestador: cada uno tomaba un archivo de bloqueo sobre una tarea y fusionaba vía git. Costó unos 20.000 dólares en tokens, y la gran lección fue que solo funcionó gracias a una suite de tests casi perfecta. Cuando todos los agentes trabajaban en una sola tarea grande, todos chocaban con el mismo bug y se pisaban unos a otros (Anthropic).
Un ingeniero usó un agent team para investigar un incidente en producción: causa raíz en unos diez minutos en lugar de los treinta a cuarenta y cinco estimados, por entre tres y cuatro veces el coste (magarcia). Vale la pena para una caída. No para una errata.
Pros: paralelismo real; los agentes pueden cuestionar las hipótesis de los demás. Contras: los tokens escalan con el número de agentes, la coordinación se come las ganancias en cualquier cosa secuencial y, como dijo una reseña de un framework de enjambre popular, el diseño se convierte en el cuello de botella (Maggie Appleton). Hasta los frameworks están dando marcha atrás: un setup popular eliminó su skill de enjambre en favor de equipos pequeños, y borró un puente entre equipos porque nadie lo usaba nunca (oh-my-claudecode).
Cómo conectar los agentes entre sí
Quita el branding y todos los frameworks —Claude Code, el Agents SDK de OpenAI, LangGraph, CrewAI, el ADK de Google— ofrecen las mismas cuatro formas:
| Forma | Cómo funciona | Úsala cuando |
|---|---|---|
| Orquestador → workers | Un agente reparte tareas, los workers devuelven resúmenes | Las subtareas son independientes o generan mucho ruido |
| Traspaso (handoff) | Un agente de triaje pasa la conversación a un especialista | El especialista debe hablar directamente con el usuario |
| Jerarquía | Orquestadores de orquestadores | Un solo coordinador tendría demasiados workers |
| Equipo de pares | Los agentes se mandan mensajes y comparten una lista de tareas | Hipótesis en competencia, ciclos escritor–revisor |
Los números sobre cuándo compensa son sorprendentemente consistentes:
- El sistema de investigación multiagente de Anthropic superó a un solo agente en un 90% en tareas de investigación, usando unas 15× los tokens de un chat. Consideran que la mayor parte del trabajo de programación encaja mal (Anthropic).
- Google probó 180 configuraciones: un coordinador central ganó un +81% en tareas paralelas, pero todas las variantes multiagente fueron entre un 39 y un 70% peores en planificación secuencial. Los agentes independientes amplificaron los errores hasta 17×; un coordinador central lo mantuvo cerca de 4× (Google Research).
- Un estudio de más de 1.600 trazas multiagente encontró que el arreglo individual más eficaz era añadir un paso de verificación: +15,6% (MAST).
- Cognition, que escribió el famoso "Don't Build Multi-Agents", actualizó su postura en abril: funciona cuando las escrituras siguen en un solo hilo y los agentes extra aportan pensamiento: un revisor con contexto limpio, un modelo más potente al que escalar (Cognition).
Y la forma que se repite en los repos que funcionan: un orquestador fino, workers con contexto fresco, estado en archivos y una puerta de revisión. Así declara un worker get-shit-done; fíjate en que dice quién tiene permiso para lanzarlo:
---
name: gsd-executor
description: Executes plans with atomic commits. Spawned by the
  execute-phase orchestrator.
tools: Read, Write, Edit, Bash, Grep, Glob
---
Todo el estado del proyecto vive en .planning/STATE.md y ROADMAP.md, nunca solo en un chat. Cualquier agente puede morir, y el siguiente retoma desde el archivo.
Si quieres un orquestador que solo pueda llamar a workers concretos, Claude Code te deja indicarlo cuando corre como sesión principal:
---
name: coordinator
tools: Agent(researcher, implementer, reviewer), Read, Grep
---
El setup con el que empezaría hoy
Si lo montara desde cero, sabiendo lo que sé ahora:
- Mantén corta la lista global: veinte o treinta skills que de verdad uses, cada una con una descripción que empiece por las palabras que diría un usuario. Comprueba lo que la herramienta muestra realmente (
/doctoren Claude Code estima lo que ocupa la lista). - Agrupa las familias detrás de routers. Nueve pasos de "revisión diaria" se convierten en una skill con nueve archivos de referencia.
- Marca las skills peligrosas como solo para el usuario. Todo lo que gaste dinero o envíe un mensaje lleva
disable-model-invocation: true. De paso libera espacio en la lista. - Usa los plugins como cajas. Un dominio —por ejemplo, producción de vídeo— se convierte en un plugin con sus agentes y sus skills juntos, activado donde haga falta.
- Nombra a los agentes por tareas, no por cargos.
researcher,reviewer,explorer, o un router que entra en otra carpeta de proyecto con sus propias instrucciones. Otra carpeta sí es una frontera de contexto real. "CTO" no lo es. - Conéctalos como orquestador → workers → revisor, con el estado en archivos. Un solo escritor. Los workers no lanzan workers.
- Recurre a un equipo solo cuando los agentes necesiten discutir: tres teorías en competencia sobre una caída, no el desarrollo de una funcionalidad.
Y una más, sacada de la documentación: si una regla tiene que cumplirse siempre, no pinta nada en una skill. Una skill es una petición. Un hook es una obligación.
La verdadera lección
Me propuse preguntar quién debería ser dueño de qué skill. La respuesta que la investigación me devolvía una y otra vez era otra pregunta: ¿dónde se rompe el contexto?
Los organigramas, los cargos, los departamentos son inventos brillantes para las personas, porque las personas no pueden abarcarlo todo a la vez. Nuestros agentes tienen un límite con otra forma. Pueden ser expertos en cualquier cosa durante unos minutos, pero solo en lo que alcanzan a ver. Así que organizarlos no consiste en dibujar cajas y líneas de reporte. Consiste en decidir qué necesita ver cada uno, y asegurarse de que nada importante se caiga entre una ventana y otra.
Monta menos agentes. Escribe mejores descripciones. Guarda el estado donde cualquiera pueda leerlo. Y deja que una sola mano sostenga la pluma.
¿Tienes ideas sobre esta publicación? ¡Discutámoslo en X!

Alösha
Construyo plataformas comunitarias, enseño salsa, escribo para encontrar a mi gente.